どうも。こんにちは。
ケミカルエンジニアのこーしです。
「まるごと学べる 異常検知の実践知」(中村謙太 著/技術評論社)を読了しましたので、読書メモを書いていきたいと思います!


まず結論から書きますと、本書は異常検知の「進め方」を現場目線で一通り掴める、初心者にこそおすすめしたい一冊です。
購入してから長いこと積読していましたが、自分で異常検知アプリを作りたいと思ったのをきっかけに、朝活・昼活で少しずつ読み進めてきました。
最初に手に取ったときは、辞書のような分厚さに驚きましたが、図解多めで丁寧に解説されていて、Pythonコードも豊富なので手を動かしながら実践的な異常検知手法を学べました。
本記事では、化学プラントでデータ解析に取り組んできたエンジニアの目線で、各章の要点と「現場あるある」を交えた所感をまとめたいと思います!
- 書籍のサポートページ(Pythonコード):ghmagazine/python_anomaly_detection_book
本書の構成
全体9章で、「可視化 → 教師あり → 教師なし(1変数・計数・多変数)→ 統計モデリング → 前処理と評価」という流れで進みます。
|
章 |
テーマ |
ひとことメモ |
|---|---|---|
|
1 |
異常検知の概要と使いどころ |
導入メリットの金額換算まで踏み込む |
|
2 |
データの概要把握と可視化 |
原因解析は「まず可視化」 |
|
3 |
教師あり学習を用いた手法 |
実務で使える場面は意外と少ない |
|
4 |
教師なし学習を用いた手法1:1変数データ |
3σ管理の前提を見直す |
|
5 |
教師なし学習を用いた手法2:計数データ |
二項分布・ポアソン分布の最尤推定 |
|
6 |
教師なし学習を用いた手法3:多変数データ |
ホテリング理論・MT法・GMM・k-NN法 |
|
7 |
統計モデリングを用いた手法:入出力があるデータ |
物理化学×統計の組合せ |
|
8 |
ベイズ統計モデリングを用いた手法:入出力があるデータ |
GLMMでロット差を扱う |
|
9 |
前処理と性能評価 |
実務でいちばん大変なところ |
それでは、読んでみて学んだ内容や感想を1章ずつ書いていきます!
第1章 異常検知の概要と使いどころ
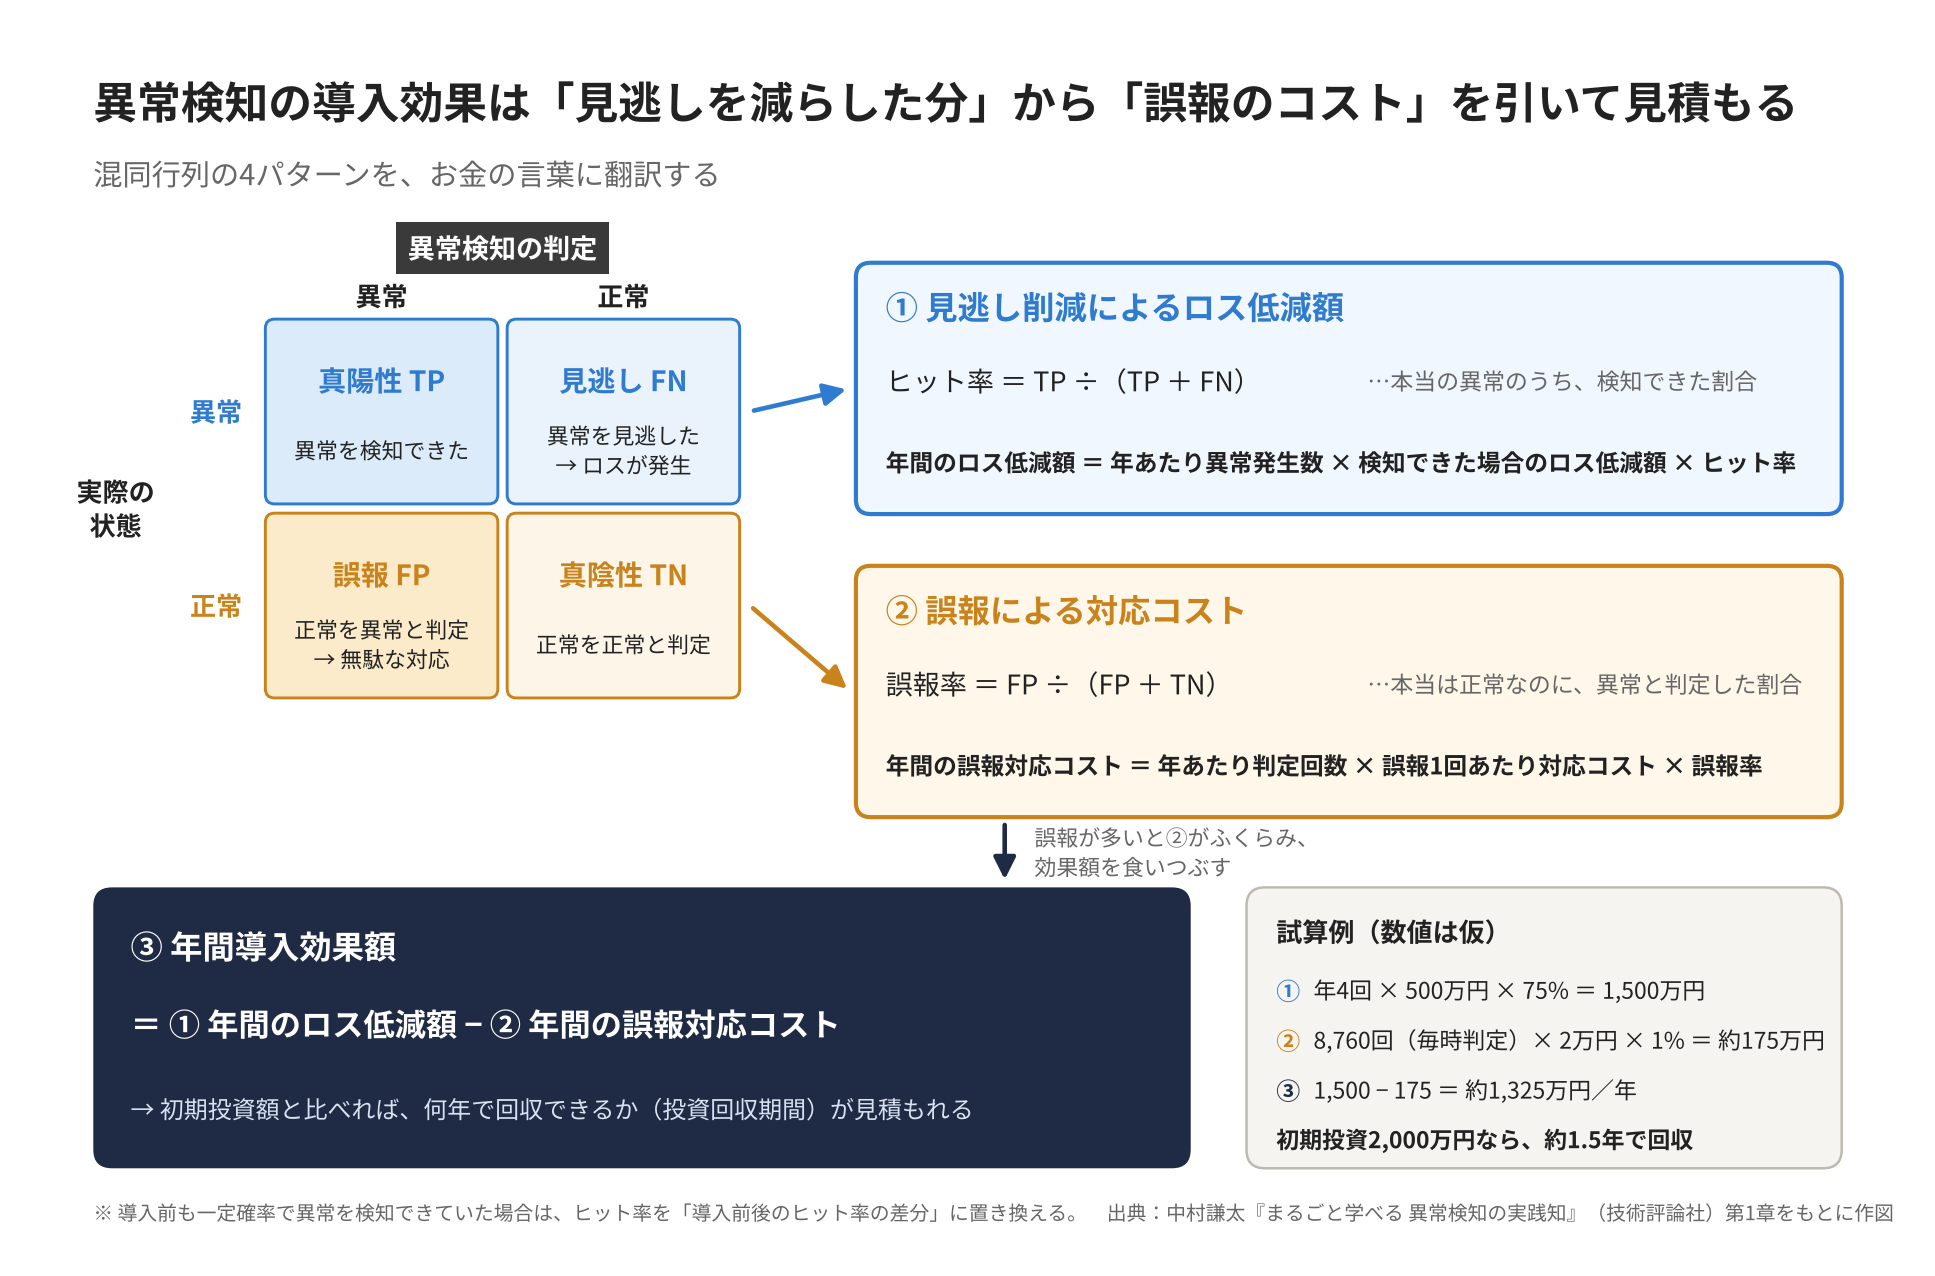
第1章では、異常検知の流れが非常に丁寧に解説されています。
特に良かったのは、他書ではあまり見かけない「異常検知によるメリットの具体化」です。
混同行列(TP・FN・FP・TN)を出発点に、「見逃しによるロス」と「誤報による対応コスト」の2つの観点から導入効果を概算します。
- 年間のロス低減額 = 年あたり異常発生数 × 検知できた場合のロス低減額 × ヒット率
- 年間の誤報対応コスト = 年あたり判定回数 × 誤報1回あたり対応コスト × 誤報率
- 年間導入効果額 = 年間のロス低減額 − 年間の誤報対応コスト
この効果額を初期投資と比べれば、投資回収期間も見積もれます。
現場でDXを進めていると「で、いくら効果があるの?」と必ず聞かれるので、関係者へ説明するときの「型」としてそのまま使えます。
誤報が増えると導入効果が目減りする構造が式で見えるのもポイントです。
「実践知」と謳っているだけあって、現場での使い方を漏れなく解説しようという姿勢が伝わってきます。
アンチパターンは「現場あるある」の宝庫
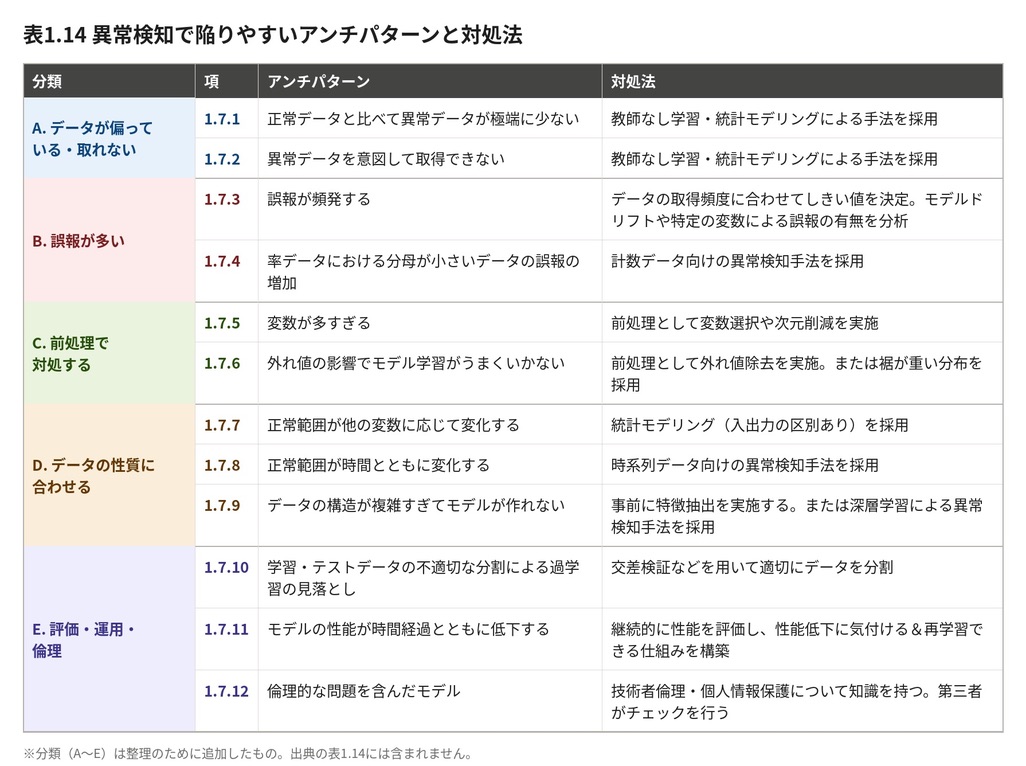
第1章には、異常検知で陷りやすいアンチパターン(失敗例)と対処法が表にまとまっていました。
下の表は、自分でA〜Eの分類を足して整理したものです。
どれも身に覚えがありますが、特に刺さった2つを紹介します。
誤報が頻発する
「見逃しを恐れてしきい値を敏感にしすぎた結果、誤報が続出する。」
まさに「現場あるある」です。
誤報が続けば警報は無視されるようになり、いざ真の異常が起きたときに対応できなくなります。
現場のことを思うなら、ある程度の見逃しリスクを引き受けるのも技術者の役目だと考えています。
第1章の「年間導入効果額」の式に誤報コストが入っているのは、まさにこの議論を数字でできるようにするためだと感じました。
変数が多すぎる
こちらも現場あるあるです。
変数を増やしすぎると、次のような問題を招きます。
- 次元の呪い
- 多重共線性
- 過学習
- 説明性の低下
モデル構築時はベストでも、運用時に上手くいかなくなることが多いです。
化学プロセスの計測器は、停機や校正のたびに特性が変わりやすいため、変数の数だけモデルドリフトの可能性が高くなってしまいます。
本書では対処法として「前処理として変数選択や次元削減を実施」が挙げられています。
現場目線では、そもそも「保守できる数の変数だけを使う」という割り切りも大事だと思います。
第2章 データの概要把握と可視化
生産現場のトラブル原因解析では、まず可視化することが何より重要です。
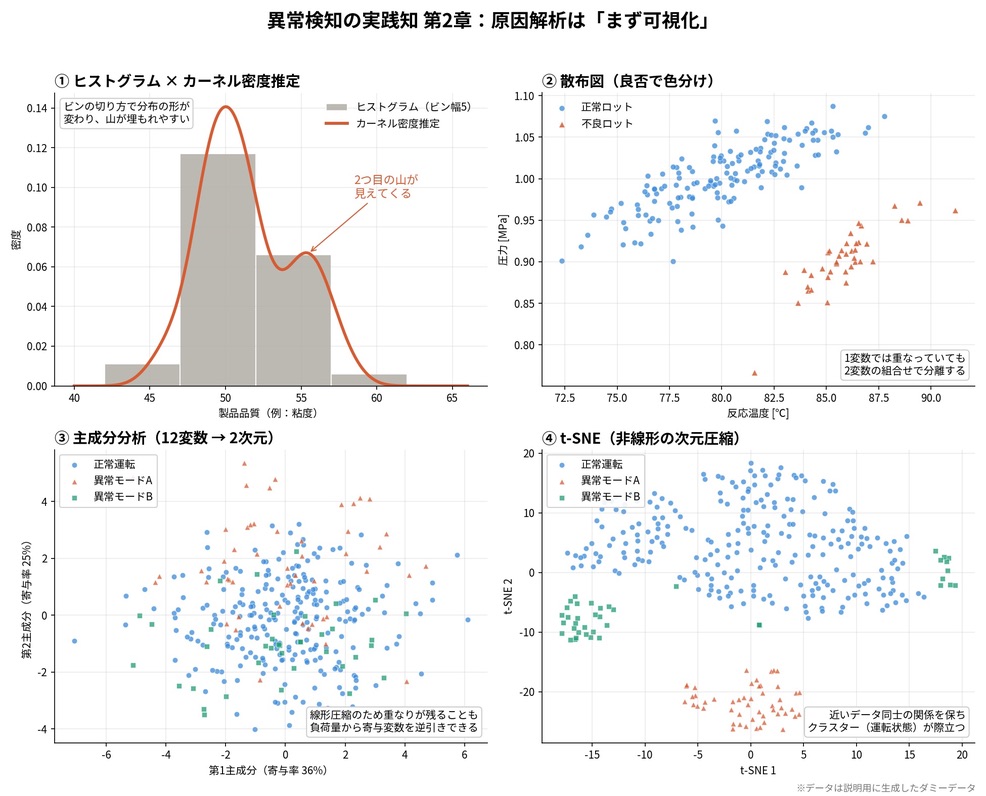
第2章「データの概要把握と可視化」では、次の手法が紹介されています。
|
手法 |
何が見えるか |
|---|---|
|
ヒストグラム |
分布の形。ただしビンの切り方で山が埋もれやすい |
|
カーネル密度推定 |
ヒストグラムで埋もれた「2つ目の山」 |
|
散布図(pairplot) |
1変数では重なる良品・不良品が、2変数の組合せで分離する |
|
主成分分析 |
多変数の全体像。負荷量から寄与変数を逆引きできる |
|
t-SNE |
非線形な次元圧縮で、運転状態ごとのクラスターが際立つ |
下の図は、説明用のダミーデータで4つの手法を並べたものです。
PCAでは重なっていた異常モードが、t-SNEではきれいに分かれています。
これらの手法だけでも、体感で7〜8割のトラブルは原因を特定できます。
それなのに、現場でこれをできる人が少ないのが実情です。
高度な機械学習より前に、まず可視化の基本を現場に根付かせることが先だと感じています。
第3章 教師あり学習を用いた手法
教師あり学習は考え方がわかりやすい反面、実務で使える場面は思ったより少ないというのが率直な実感です。
理由は大きく2つあります。
- そもそも異常データが少ない
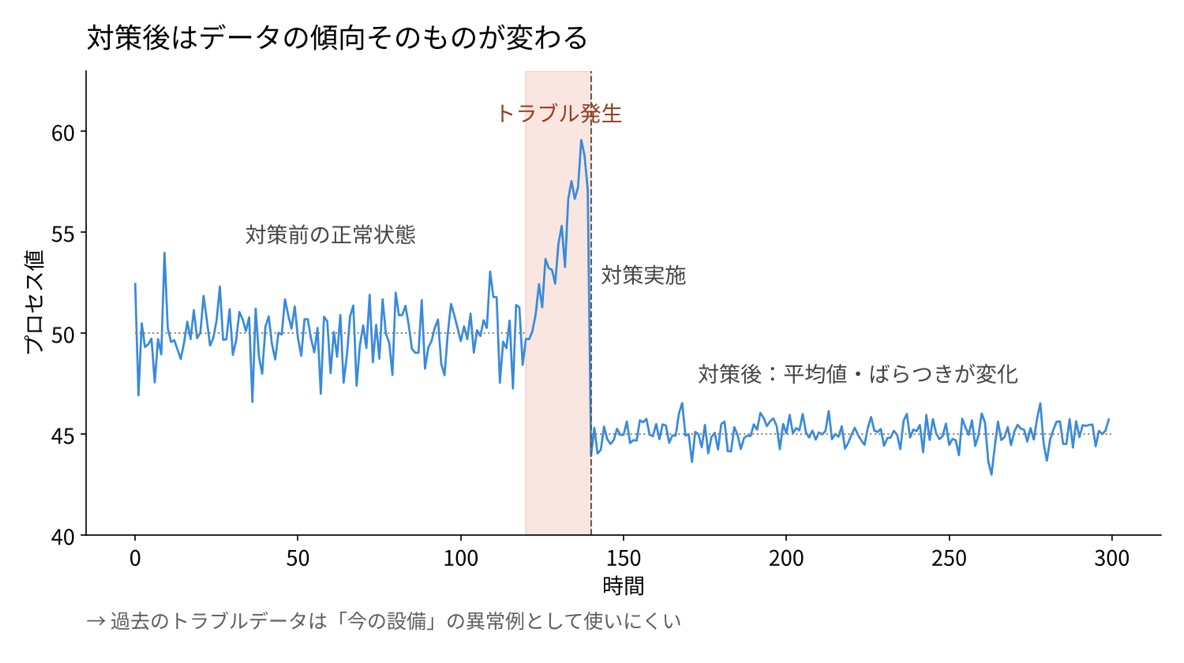
化学プラントでは大きなトラブルは年に数回あるかないかです。 - 対策するとデータの傾向そのものが変わる
トラブルが起きれば対策を打つので、その後は平均値やばらつきが変わってしまいます。
過去のトラブルデータは、「今の設備」の異常例としては使いにくいのです。
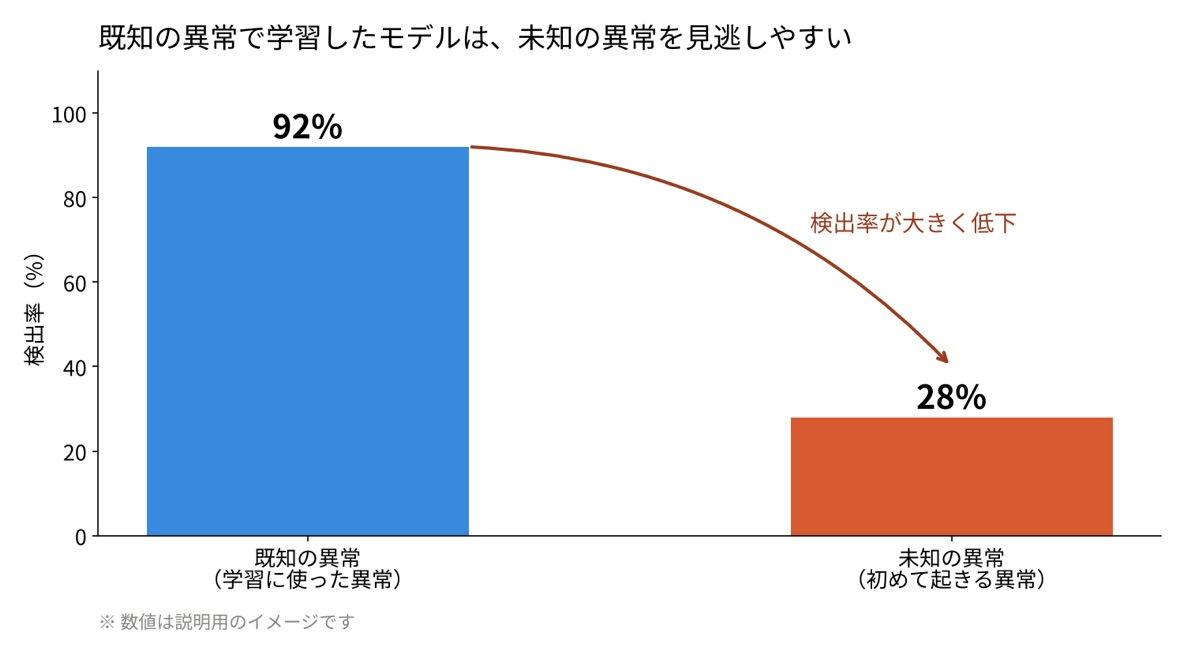
さらに、既知の異常で学習したモデルは、初めて起きる未知の異常を見逃しやすいという問題もあります。
未知の異常を検知したいなら、既知の異常で作った教師データはむしろ足かせになります。
だからこそ、本書の後半(第4章以降)で扱う教師なし学習・統計モデリングが、製造現場では主戦力になると考えています。
第4章 教師なし学習を用いた手法1:1変数データ
第4章「教師なし学習を用いた手法1:1変数データ」の主役は確率分布です。
統計検定1級でさんざん勉強した分野が、異常検知でも大活躍することがわかりました。
正規分布・対数正規分布・カイ二乗分布・t分布・二項分布・ポアソン分布・指数分布・ガンマ分布・一様分布が、「どんな現象に合うか」という観点で整理されています。
|
名称 |
確率変数の形態 |
台 |
モデリングに適した現象 |
適用例 |
|---|---|---|---|---|
|
正規分布 |
連続型 |
(−∞, ∞) |
多くのケースに適する |
最も一般的に用いられる |
|
対数正規分布 |
連続型 |
(0, ∞) |
左右非対称な分布かつ正の値で表される現象 |
年収 |
|
カイ二乗分布 |
連続型 |
[0, ∞) |
正規分布に従う変数の二乗和 |
正規分布に従うモデルの異常度 |
|
スチューデントのt分布 |
連続型 |
(−∞, ∞) |
外れ値が多い(裾が長い)現象 |
学力テストの成績 |
|
二項分布 |
離散型 |
{0, 1, …, n} |
一定確率で起こる現象の発生数(試行数が有限の場合) |
野球の安打数、1ロットあたり不良数 |
|
ポアソン分布 |
離散型 |
{0, 1, …, ∞} |
一定確率で起こる現象の面積や時間あたり発生数 |
面積あたり不良数、時間あたり故障数 |
|
指数分布 |
連続型 |
[0, ∞) |
一定確率で起こる現象の発生間隔 |
タスクの到着間隔、システムの故障間隔 |
|
ガンマ分布 |
連続型 |
[0, ∞) |
指数分布で表せる現象の和、左右非対称な分布で表せる現象 |
予備系を備えたシステムの故障間隔、体重 |
|
一様分布 |
連続型 or 離散型 |
[min, max] |
台の範囲内で等確率で起こる現象 |
サイコロの目 |
プロセスデータが正規分布に近い理由
温度計や圧力計のプロセスデータは正規分布に従うことが多いと感じていました。
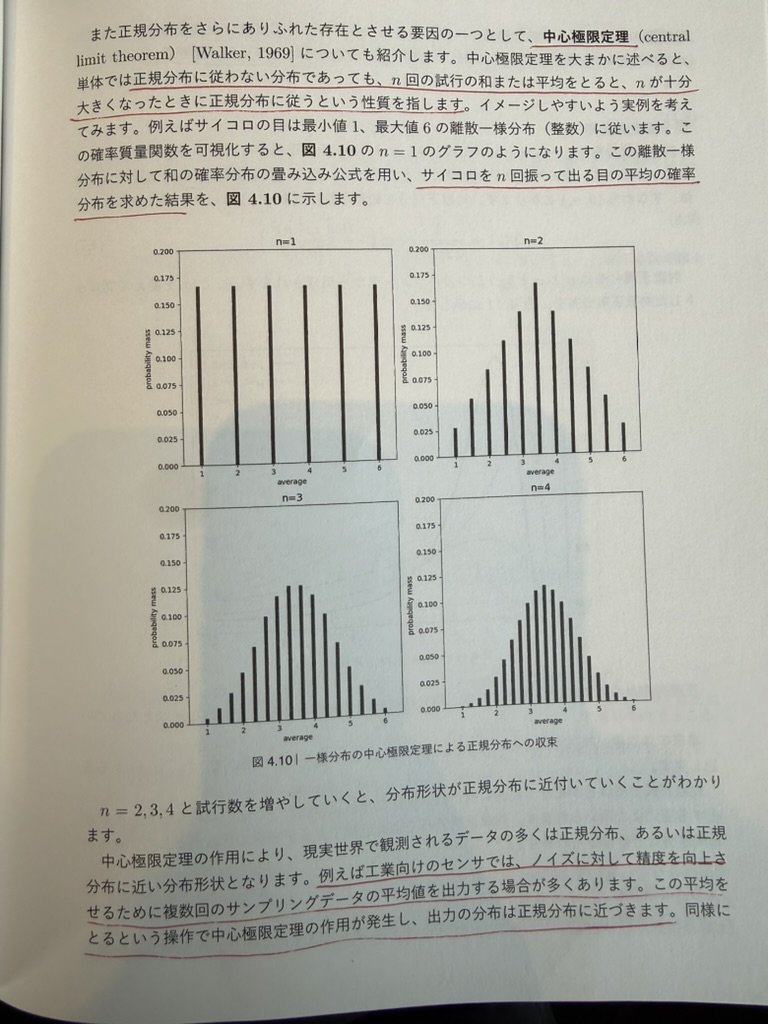
その背景の一つが、中心極限定理だったようです。
工業向けのセンサーは、ノイズ対策として複数回のサンプリング値を平均して出力することが多いそうです。
この「平均をとる」操作で中心極限定理が働き、出力の分布が正規分布に近づきます。
センサー側で平均していることは知らなかったので、現場の計測器をもっと詳しく知らないといけないと反省しました。
3σ管理をそのまま当てはめない
製造現場の定番である3σ管理は、正規分布を前提にした手法です。
次のようなデータにそのまま当てはめると、誤報や見逃しが増えてしまいます。
- 不純物濃度のように、0が下限で左右非対称になるデータ
- 品種切替で山が複数できるデータ
まずヒストグラムを描いて分布を確かめるのが先です。
現場ではトレンドグラフは毎日見ても、ヒストグラムを描く文化がありません。
ここを変えていきたいところですね。
第5章 教師なし学習を用いた手法2:計数データ
第5章「教師なし学習を用いた手法2:計数データ」では、不良数や故障数のような「数えるデータ」を二項分布・ポアソン分布で扱います。
最尤推定は統計検定1級で散々やった範囲なので、すんなり読めました。
これまで「統計検定1級の取得は必須ではない」と考えていましたが、この章を読んでいる内に考えが変わってきました。
確率分布の知識があると、異常検知手法の「なぜそうなるのか」が自然に理解できます。
自分の経験から言うと、例えば次の傾向があります。
- 確率分布で結論を出せる問題は「運用しやすい」
仕組みがシンプルで、かつ現場が理解しやすいからです - 機械学習に頼らざるを得ないデータは、手法を変える前にデータの取り方を疑う
複雑なモデルでしか説明できないのは、測るべきものを測れていないサインかもしれません
第6章 教師なし学習を用いた手法3:多変数データ
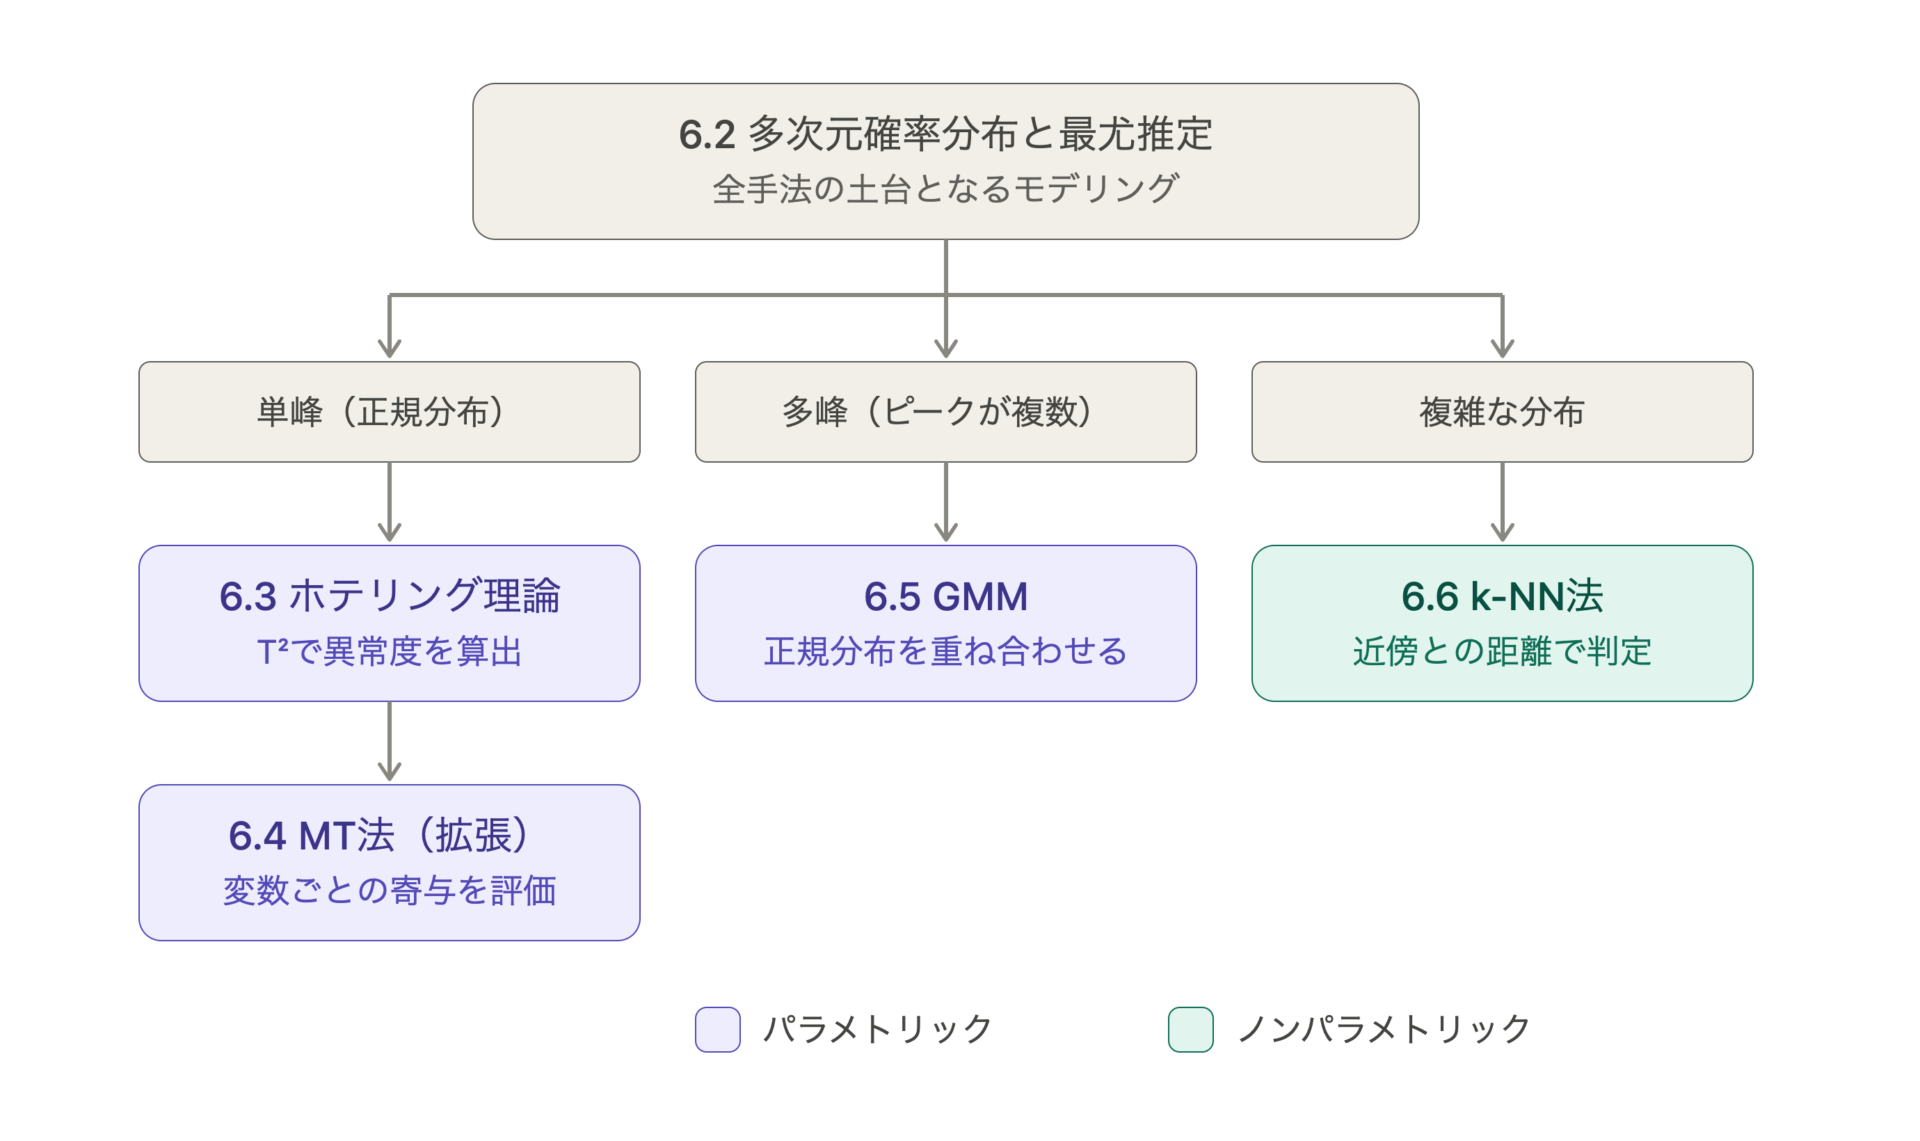
第6章「教師なし学習を用いた手法3:多変数データ」では、現場でよく使う異常検知手法の概要とPythonコードが学べます。
多次元確率分布と最尤推定を土台に、データの分布の形で手法を使い分ける構成です。
|
分布の形 |
手法 |
ポイント |
|---|---|---|
|
単峰(正規分布) |
ホテリング理論 |
T²統計量で異常度を算出 |
|
単峰(正規分布) |
MT法(マハラノビス・タグチ法) |
変数ごとの寄与を評価 |
|
多峰(ピークが複数) |
GMM |
正規分布を重ね合わせる |
|
複雑な分布 |
k-NN法 |
近傍との距離で判定(ノンパラメトリック) |
品種切替がある化学プラントでは、「多峰 → GMM」という選択肢を持っておくと便利そうです。
なお、LOF(局所外れ値因子法)は第9章で扱われています。
第7章 統計モデリングを用いた手法:入出力があるデータ
第7章「統計モデリングを用いた手法:入出力があるデータ」を読んで、以前取り組んだ蒸留塔の事例を思い出しました。
温度と圧力からボトムの組成を推算し、分析値とのズレで異常を検知するというものです。
ポイントは、温度だけでは組成を正しく推算できないことです。
- 圧力が上がると、組成が変わっていなくても温度は上がる
- 温度だけで推算すると、この温度上昇を「軽沸成分が減った」と誤って解釈してしまう
- 圧力補正を入れた統計モデルなら、圧力変化の影響を取り除いたうえで、本当の組成変化だけを検知できる
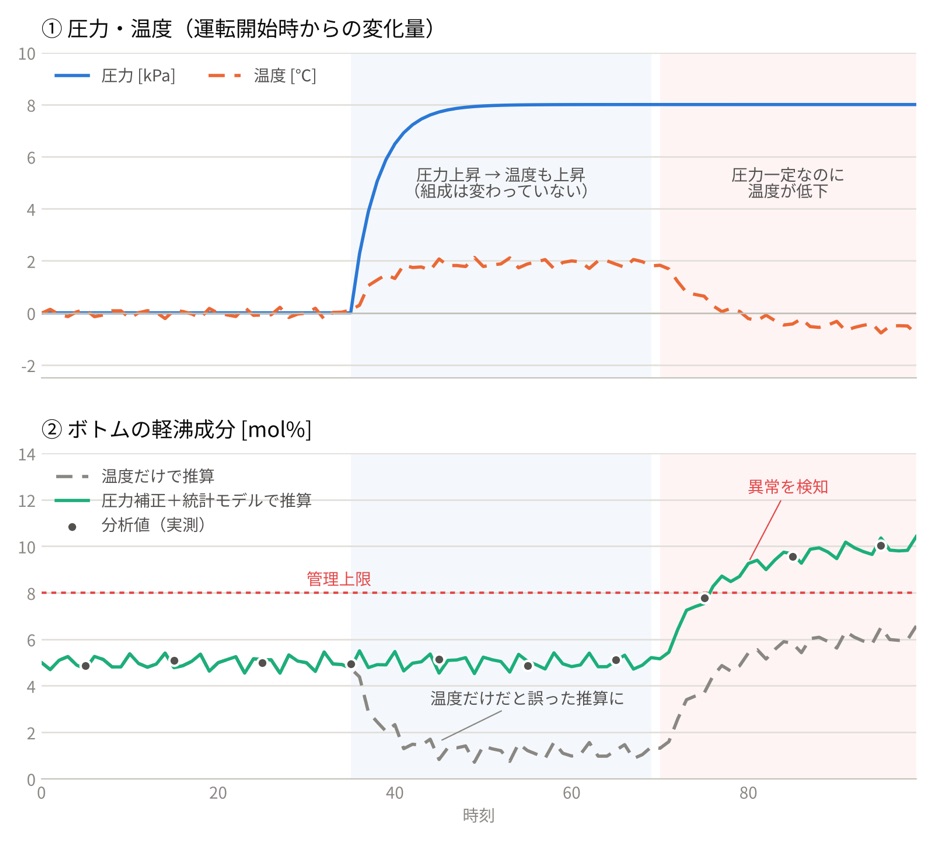
物理化学の知識と統計モデリングを組み合わせた、面白い事例だったと思います。
ただし、モデルの劣化対応や再学習など運用面のハードルが高く、化学プラントでの適用事例はまだ少ない印象です。
第8章 ベイズ統計モデリングを用いた手法:入出力があるデータ
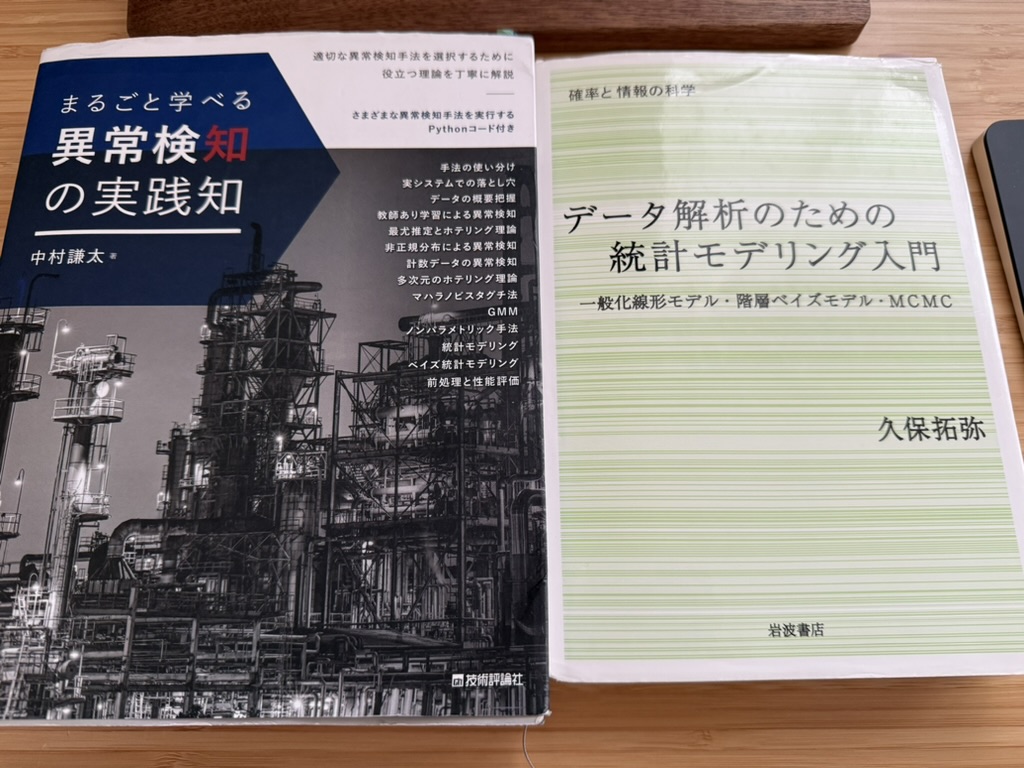
ベイズ統計モデリングは、統計検定準1級の試験対策で久保先生の名著『データ解析のための統計モデリング入門』で学んで以来でした。
当時は試験問題も即答できましたが、実務では使っていなかったのでほぼ忘れていました。
本書はその復習のような内容なので、久保本と併せて読むと理解が深まると思いました。
いちばん実務に使えそうだと感じたのは、GLMとGLMMの比較です。
- GLM(ロット差を無視):正常範囲が狭くなり、正常なデータまで異常と判定(誤検知)してしまう
- GLMM(ロットを変量効果に):ロット間のばらつきをモデルに取り込むので、正常範囲が適切な幅になり、誤検知が大きく減る
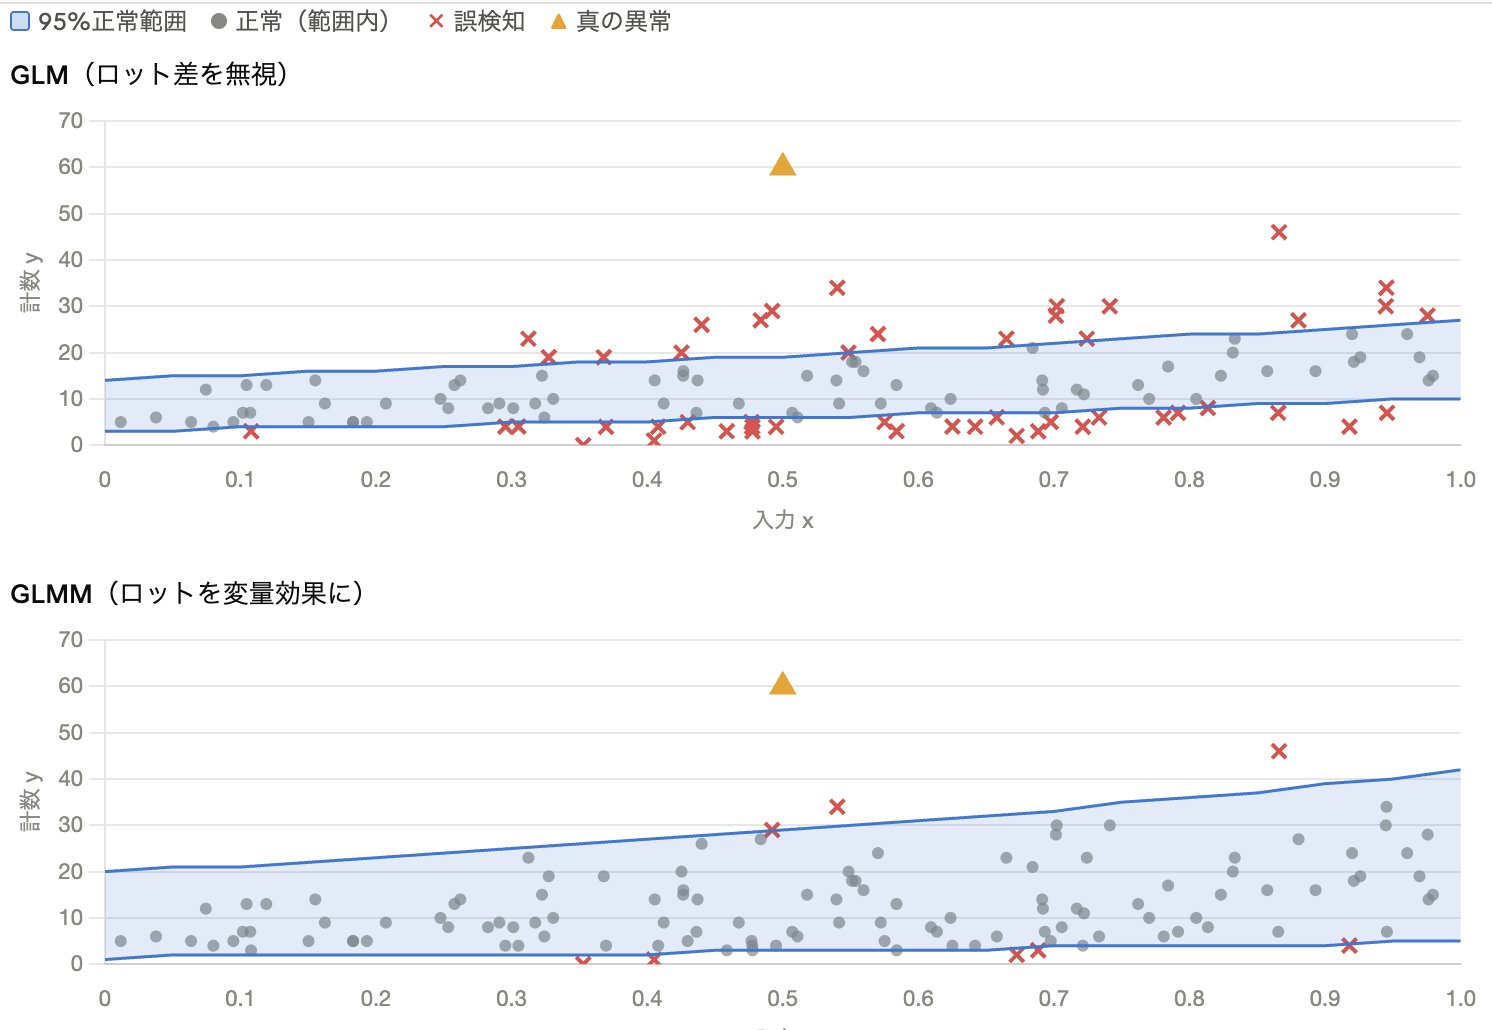
製造現場では、ロットや装置の差はつきものです。
「差があることを前提に正常範囲を決める」という考え方は、第1章の「誤報が頻発する」問題への有力な答えの一つだと感じました。
この機会に実装してみたいところです。
第9章 前処理と性能評価
最終章は「前処理と性能評価」です。
実際の異常検知では、前処理が死ぬほど大変です。
特につらいのが、データに残らない条件変更や運転操作が混ざっているケースです。
「この日だけ値がおかしい」と思って調べたら、実は手動操作をしていたということが続くと、本気で心が折れます。
統計手法を学ぶのと同じくらい、ドメイン知識とデータ設計(何をどう記録するか)に力を注ぐ必要があると改めて感じました。
読み終えての感想
本書は、図解・数式・コードのバランスが良く、分厚いわりに読みやすい本でした。
そして、異常検知の「進め方」が一通り解説されているので、初心者におすすめです。
一方で、理論の詳細は参考図書に譲っている箇所が多いので、本書で異常検知の流れを掴んでから、他の専門書に進むのがベストだと思います。
異常検知を実務で扱うなら読んでおきたい本
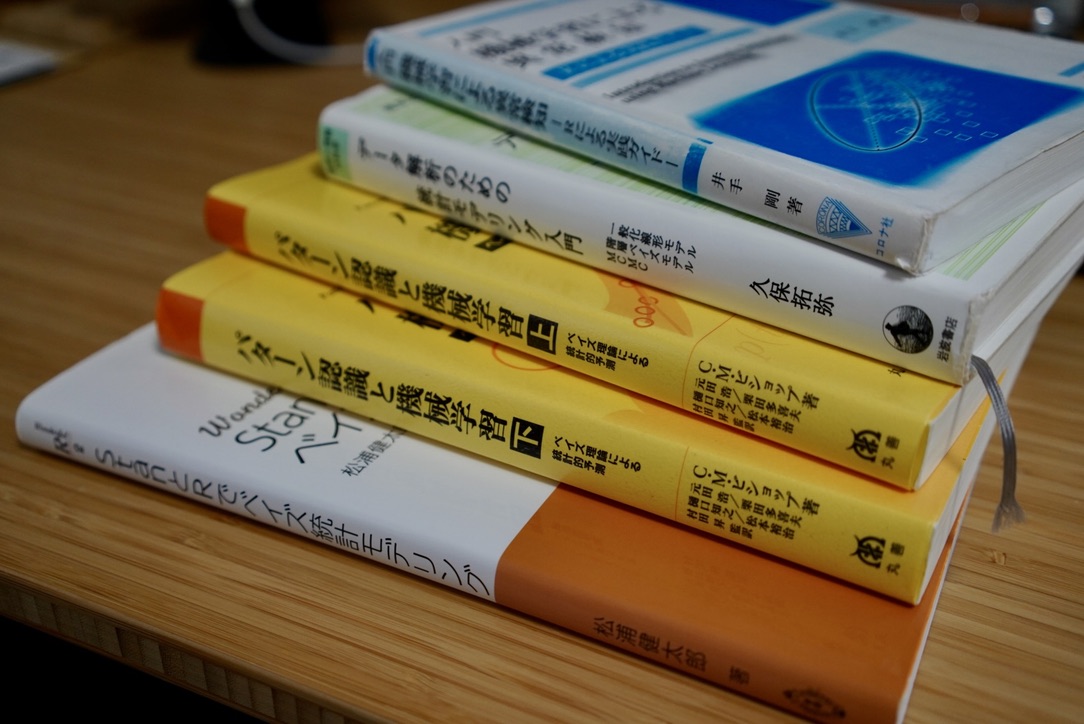
本書を読み終えて、異常検知を実務で扱うなら次の5冊くらいは読んでおいた方が良いと感じました。
|
|
書名 |
著者 |
私の学習状況 |
|---|---|---|---|
|
① |
井手剛 |
読了 |
|
|
② |
久保拓弥 |
読了 |
|
|
③ |
松浦健太郎 |
これから |
|
|
④ |
C.M.ビショップ |
これから |
|
|
⑤ |
中村謙太 |
読了 |
著者の学習ロードマップも参考になる
本書の著者が、gihyo.jpでデータサイエンスの学習ロードマップを紹介しています(記事はこちら)
統計の基礎 → 統計モデリング → 異常検知での実践 → ビジネスドリブンな実践能力、という4段階の構成です。
|
ステップ |
書名 |
著者(刊行年) |
おすすめポイント |
|---|---|---|---|
|
1. 統計の基礎 |
馬場(2022) |
統計理論とPythonでの実践を平易に学べる、最初の一冊 |
|
|
1. 統計の基礎 |
山田(2008) |
Rで統計を学びたい人向けの入門書 |
|
|
1. 統計の基礎 |
東京大学教養学部(1991) |
確率分布・検定・回帰の理論的背景を数式で理解できる |
|
|
1. 統計の基礎 |
東京大学教養学部(1992) |
『統計学入門』と併せて基礎力を固める |
|
|
1. 統計の基礎 |
東京大学教養学部(1994) |
同シリーズ。合わせて読むと強力な統計基礎力に |
|
|
2. 統計モデリング |
久保(2012) |
統計モデリングの定番。最尤推定のR実装も解説 |
|
|
2. 統計モデリング |
馬場(2019) |
MCMCによるベイズ推定を図表入りで丁寧に解説 |
|
|
2. 統計モデリング |
森賀(2022) |
Pythonでベイズ推定をやりたい人向け |
|
|
3. 異常検知での実践 |
井手(2015) |
各手法の背景にある統計理論を省略少なく解説。Rの実装例も豊富 |
|
|
3. 異常検知での実践 |
中村(2025) |
現場の課題と解決策、Python実装まで。ステップ2でも「Pythonで最尤推定を学べる本」として紹介 |
|
|
4. ビジネスドリブンな実践 |
森下(2025) |
ビジネス課題をデータサイエンスで解ける問題に変換するフレームワーク |
|
|
4. ビジネスドリブンな実践 |
大城(2020) |
組織調整・マネジメント・出口戦略まで含めたプロジェクトの進め方 |
|
|
4. ビジネスドリブンな実践 |
ゆずたそ(2021) |
分析用データの取得環境を整える、データ基盤整備の進め方 |
紹介された12冊のうち7冊は読了済みで、残りの5冊も読みたいと思ってすでに購入(積読)していました。
自分で書いた記事かと勘違いするくらい、思考回路が似ていて驚きました。
近いうちに、ステップ4の『AI・データ分析プロジェクトのすべて』と『実践的データ基盤への処方箋』を読む予定です。
手法だけでなく、プロジェクトの進め方やデータ基盤まで含めて学ぶのが、実務で成果を出す近道だと思います。
まとめ
「まるごと学べる 異常検知の実践知」は、手法の理論だけでなく、「現場でどう使い、どこでつまずくか」まで扱った本です。
よって、次のような方におすすめします。
- これから異常検知に取り組む、製造現場のエンジニア
- 手法は知っているが、どれを選べばよいか迷っている人
- 異常検知の導入効果を、上司や関係者に金額で説明したい人
- 統計検定で学んだ確率分布を、実務につなげたい人
私自身は、本書で学んだ手法を参考に、異常検知アプリの自作を進めていきます。
まずは「ヒストグラムで分布を確かめる」ところから、現場の文化を変えていきたいと思います。
